CUDA tile

一、什么是 Tile?

在 CUDA 编程中,Tile(瓦片 / 分块) 指的是把一个大问题切成许多大小固定、能装载进快速存储(共享内存 / 寄存器)的小块,让线程块(block)或线程(thread)以这些小块为单位循环处理。

简而言之,Tile 就是"数据搬运"与"数据计算"之间的桥梁——它让同一块数据被多次复用,从而把全局内存的带宽瓶颈转化为片上高速存储的吞吐问题。

以矩阵乘法 C = A × B 为例,朴素实现中每个 C 元素都要重新读一遍 A 的一行和 B 的一列,重复读取量是 O(N) 级的。而 tiling 让每个线程块只从全局内存加载一次数据,然后在共享内存里反复使用,全局内存访问量从 O(N³) 降到 O(N²)。

二、Tiling 的两个维度

2.1 Block-level Tiling (使用共享内存)

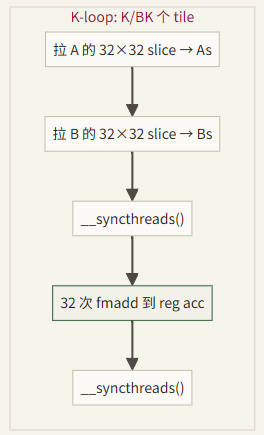
把 C 切成 32×32 的 tile,每个 block 算一个 tile。K 维度也切:

线程块协作把一块数据搬进共享内存,块内所有线程共享这一份数据。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
constexpr int BM = 32, BN = 32, BK = 16;

__global__ void matmulTiled(const float* A, const float* B, float* C,
int M, int N, int K) {
__shared__ float As[BM][BK];
__shared__ float Bs[BK][BN];

int by = blockIdx.y, bx = blockIdx.x;
int ty = threadIdx.y, tx = threadIdx.x;
int row = by * TILE + ty;
int col = bx * TILE + tx;

float sum = 0.0f;
const int numTiles = (K + TILE - 1) / TILE;

for (int t = 0; t < numTiles; ++t) {
// 全局内存 -> 共享内存(协作加载)
if (row < M && t + tx < K) As[ty][tx] = A[row * K + tx];
else As[ty][tx] = 0.0f;
if (t + ty < K && col < N) Bs[ty][tx] = B[(t + ty) * N + col];
else Bs[ty][tx] = 0.0f;
__syncthreads(); // 等待 tile 全部就位

// 在片上完成 TILE 次乘加
#pragma unroll
for (int k = 0; k < BK; ++k)
sum += As[ty][k] * Bs[k][tx];
__syncthreads(); // 防止下一轮覆盖尚未读完的数据
}

if (row < M && col < N)
C[row * N + col] = sum;
}

补充:代码说明

  • 核心思想:一个 block 只算 C 的一小块
1
2
3
constexpr int BM = 32, BN = 32, BK = 32;
__shared__ float As[BM][BK]; // 32 x 32,存 A 的一个 tile
__shared__ float Bs[BK][BN]; // 32 x 32,存 B 的一个 tile
  • 一个 block 负责输出 C 的一个 BM × BN = 32 × 32 的 tile。
  • 一个 block 有 32 × 32 = 1024 个线程,即每个线程正好对应输出 tile 中一个元素。

一个 block 负责 C 的:

1
2
行范围:[by*BM, by*BM + BM)
列范围:[bx*BN, bx*BN + BN)

也就是说:每个线程 (ty, tx) 负责计算 C[row][col] 一个元素。

假设 M = N = K = 64,那么 C 是 64×64。我们不可能让一个 block 一次算完,所以把 C 切成 32×32 的小块(tile):

1
2
3
4
5
6
7
8
C (64x64) 切成 2x2 个 tile:

bx=0 bx=1
┌────────┬────────┐
by=0 │ tile00 │ tile01 │
├────────┼────────┤
by=1 │ tile10 │ tile11 │
└────────┴────────┘
  • (by, bx) 就是哪个 tile。
  • 每个 tile 是 32×32,由一个 block 负责。

一个 block 有 32×32 = 1024 个线程,排列成:

1
2
3
4
5
6
threadIdx.x = tx:  0  1  2 ... 31   (横向)
threadIdx.y = ty: 0
1
2
...
31 (纵向)

我们让每个线程负责 tile 里的一个元素,就像把 1024 个格子分给 1024 个人:

1
2
3
4
5
        tx=0  tx=1  tx=2 ...
ty=0 T00 T01 T02
ty=1 T10 T11 T12
ty=2 T20 T21 T22
...

线程 (ty, tx) 就是 tile 里第 ty 行、第 tx 列的那个格子。

线程 (ty, tx) 在 tile 内的位置是 (ty, tx),但 tile 本身在 C 里有偏移:

  • tile 的左上角在 C 中的位置是 (by*32, bx*32)
  • 线程 (ty, tx) 在 tile 内偏移 (ty, tx)
  • 所以它在 C 中的全局位置是:
1
2
row = by * 32 + ty     ← 全局第几行
col = bx * 32 + tx ← 全局第几列

这就是代码里这两行的由来:

1
2
int row = by * BM + ty;   // 全局行 = block 行起点 + 线程行偏移
int col = bx * BN + tx; // 全局列 = block 列起点 + 线程列偏移

接下来看这段代码:

1
As[ty][tx] = A[row * K + kt + tx];

回忆分块矩阵乘。要算 C 的这块 tile,需要:

  • A 的一段行 (对应 C 的这些 row)
  • B 的一段列 (对应 C 的这些 col)

具体来说,C 的这个 tile (全局行 by*32..by*32+31)在 K 维度上要扫过整条 K,但一次只搬一个 K-tile(宽 32):

1
2
3
4
5
6
7
A 的这块(要搬到 As):
kt kt+32
by*32 ┌────────┐
│ │
│ As │ ← 32 行(行方向) x 32 列(K方向)
│ │
by*32+32└────────┘

As 的形状是 32(行) × 32(K列),和我们线程的 (ty, tx) 网格正好对应:

  • As 的第 ty 行 ← A 的全局第 row = by*32 + ty 行
  • As 的第 tx 列 ← A 的全局第 kt + tx 列(在这个 K-tile 内的第 tx 列)

所以:

1
2
As[ty][tx]  对应  A[row][kt + tx]
对应 A[row * K + kt + tx]

B 同理。

矩阵乘定义:

1
C[i][j] = Σ_k  A[i][k] * B[k][j]

我们的线程负责 C[row][col],即 i = ty(tile 内行)、j = tx(tile 内列)。那么:

1
C[ty][tx] = Σ_k  A[ty][k] * B[k][tx]

而共享内存里:

  • A[ty][k] 就是 As[ty][k](A 的 tile 存储)
  • B[k][tx] 就是 Bs[k][tx](B 的 tile 存储)

所以:

1
acc += As[ty][k] * Bs[k][tx];

这里 k 是 tile 内的 K 偏移,从 0 到 31。 因为每个线程负责一个输出元素,它需要沿 K 方向把 32 个数乘起来累加。

2.2 Thread-level Tiling (使用寄存器)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
constexpr int BM = 64, BN = 64, BK = 16;
constexpr int TM = 4, TN = 4; // each thread computes 4x4 of C

__global__ void matmul_2d_tile(const float* A, const float* B, float* C,
int M, int N, int K) {
__shared__ float As[BM][BK];
__shared__ float Bs[BK][BN];

int by = blockIdx.y, bx = blockIdx.x;
int ty = threadIdx.y, tx = threadIdx.x;

int row0 = by * BM + ty * TM;
int col0 = bx * BN + tx * TN;

float acc[TM][TN] = {0};

// each tile: load BM*BK + BK*BN floats with the 16x16 thread block
// 16*16 = 256 threads, BM*BK = 1024 elems → each thread loads 4 of A, 4 of B
const int threads_per_block = 16 * 16;
const int tid = ty * 16 + tx;

for (int kt = 0; kt < K; kt += BK) {
// load As (BM=64 x BK=16 = 1024 floats), 256 threads × 4 each
#pragma unroll
for (int i = 0; i < 4; ++i) {
int load_id = i * threads_per_block + tid;
int r = load_id / BK, c = load_id % BK;
int gr = by * BM + r, gc = kt + c;
As[r][c] = (gr < M && gc < K) ? A[gr * K + gc] : 0.f;
}
// load Bs (BK=16 x BN=64 = 1024 floats)
#pragma unroll
for (int i = 0; i < 4; ++i) {
int load_id = i * threads_per_block + tid;
int r = load_id / BN, c = load_id % BN;
int gr = kt + r, gc = bx * BN + c;
Bs[r][c] = (gr < K && gc < N) ? B[gr * N + gc] : 0.f;
}
__syncthreads();

#pragma unroll
for (int k = 0; k < BK; ++k) {
float a_reg[TM], b_reg[TN];
#pragma unroll
for (int i = 0; i < TM; ++i) a_reg[i] = As[ty * TM + i][k];
#pragma unroll
for (int j = 0; j < TN; ++j) b_reg[j] = Bs[k][tx * TN + j];
#pragma unroll
for (int i = 0; i < TM; ++i)
#pragma unroll
for (int j = 0; j < TN; ++j)
acc[i][j] += a_reg[i] * b_reg[j];
}
__syncthreads();
}

#pragma unroll
for (int i = 0; i < TM; ++i)
#pragma unroll
for (int j = 0; j < TN; ++j) {
int r = row0 + i, c = col0 + j;
if (r < M && c < N) C[r * N + c] = acc[i][j];
}
}

三、应用场景

场景 Tile 的对象 收益来源
矩阵乘法 A 的行块、B 的列块 输入复用降到 O(N²)
矩阵转置 输入 / 输出 tile 合并访存,避免 uncoalesced
卷积 / Stencil 输入 halo 区域 邻域重复使用
归约 每线程多元素 + 块内树形 减少同步与原子操作
多维数组 2D → 1D 展平 访存带宽利用率最大化

以转置为例,tiling 是解决"读合并、写不合并"矛盾的必备手段:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
constexpr int TILE = 32;

__global__ void transpose(const float* in, float* out, int rows, int cols) {
__shared__ float tile[TILE][TILE + 1]; // +1 避免 bank conflict

int x = blockIdx.x * TILE + threadIdx.x;
int y = blockIdx.y * TILE + threadIdx.y;

if (x < cols && y < rows)
tile[threadIdx.y][threadIdx.x] = in[y * cols + x];

__syncthreads();

x = blockIdx.y * TILE + threadIdx.x;
y = blockIdx.x * TILE + threadIdx.y;
if (x < rows && y < cols)
out[y * rows + x] = tile[threadIdx.x][threadIdx.y];
}

四、注意

Tile 不是越大越好,需要平衡以下几个因素:

1. Tile 大小 vs 占用率(Occupancy) 共享内存是有限的(如 SM 上 48KB~164KB)。tile 越大,单个 block 占用越多,能同时驻留的 block 越少。必须在"数据复用率"和"延迟掩盖能力"之间找平衡点。

2. Bank Conflict 共享内存被划分成 32 个 bank。若同一 warp 的多个线程访问同一 bank 的不同地址,会串行化。典型对策:
  • Padding(如上例 [TILE][TILE+1])
  • 交换索引布局
  • 使用 swizzle(CUTLASS 常用的 XOR 打散)

3. 同步开销 每个 tile 迭代至少两次 __syncthreads()。tile 太小 → 同步太频繁;tile 太大 → 并行度不足。

4. 边界检查 当矩阵维度不是 tile 尺寸的整数倍时,加载阶段需要判断越界并用 0 填充(对加法/乘法是恒等元)。


CUDA tile
http://example.com/2026/07/18/CUDA-tile/
作者
Yu xin
发布于
2026年7月18日
许可协议