CUDA Streams
一、流的基本概念
用到 CUDA 的程序一般需要处理海量的数据,内存带宽经常会成为主要的瓶颈。在 Streams 的帮助下,CUDA 程序可以有效地将内存读取和数值运算并行,从而提升数据的吞吐量。
应用程序通过流来管理并发操作,流是一系列按顺序执行的命令。不同的流可能无序或并发地执行命令,但此行为并不保证。流上的命令在依赖关系满足时执行,这些依赖可能来自同一流或其他流。同步调用(synchronize call)可以确保所有启动的命令已完成。
任何 CUDA 操作都存在于某个 CUDA 流中,要么是默认流(default stream),也称为空流(null stream),要么是明确指定的非空流。
1.1 流的创建与销毁
1 | |
实例:
1 | |
1.2 默认流
又叫隐式流,NULL 流。
所有的 CUDA 操作默认运行在隐式流里。隐式流里的 GPU task 和 CPU 端计算是同步的。例:
1 | |
在执行 int n = 1 之前,必须等前面三行执行完才会执行它。
1.3 显式流
显式流里的 GPU task 和 CPU 端计算是异步的。不同显式流内的 GPU task执行也是异步的。
1 | |
如果用第一种调用方式,说明核函数没有使用动态共享内存,而且在默认流中执行;
如果用第二种调用方式,说明核函数在默认流中执行,但使用了 N_shared 字节的动态共享内存;
如果用第三种调用方式,则说明核函数在编号为 stream_id 的 CUDA 流中执行,而且使用了 N_shared 字节的动态共享内存。
在使用非空流但不使用动态共享内存的情况下,必须使用上述第三种调用方式,并将 N_shared 设置为零:
1 | |
1.4 流状态查询
为了实现不同 CUDA 流之间的并发,主机在向某个 CUDA 流中发布一系列命令之后必须马上获得程序的控制权,不用等待该 CUDA 流中的命令在设备中执行完毕。这样,就可以通过主机产生多个相互独立的 CUDA 流。
为了检查一个 CUDA 流中的所有操作是否都在设备中执行完毕, CUDA 运行时 API 提供了如下函数:
1 | |
cudaDeviceSynchronize() 会等待直到所有主机线程的所有流中的所有前面命令都已完成。
1 | |
cudaStreamSynchronize() 接受一个流作为参数,并等待直到给定流中的所有前面命令都已完成。它可用于同步主机与特定流,同时允许其他流继续在设备上执行。
1 | |
cudaStreamWaitEvent() 接受一个流和一个事件作为参数,并使得所有在调用 cudaStreamWaitEvent() 之后添加到给定流的命令延迟其执行,直到给定事件已完成。
1 | |
cudaStreamQuery 不会阻塞主机,只是检查 CUDA 流 stream 中的所有操作是否都执行完毕。若是,返回 cudaSuccess,否则返回 cudaErrorNotReady。
1 | |
二、Stream 为什么有效?
- PCIe 总线传输速度慢,是瓶颈,会导致传输数据的时候 GPU 处于空闲等待状态。多流可以实现数据传输与 kernel 计算的并行。
- 一个 kernel 往往用不了整个 GPU 的算力。多流可以让多个 kernel 同时计算,充分利用 GPU 算力。
2.1 默认流的表现
1 | |
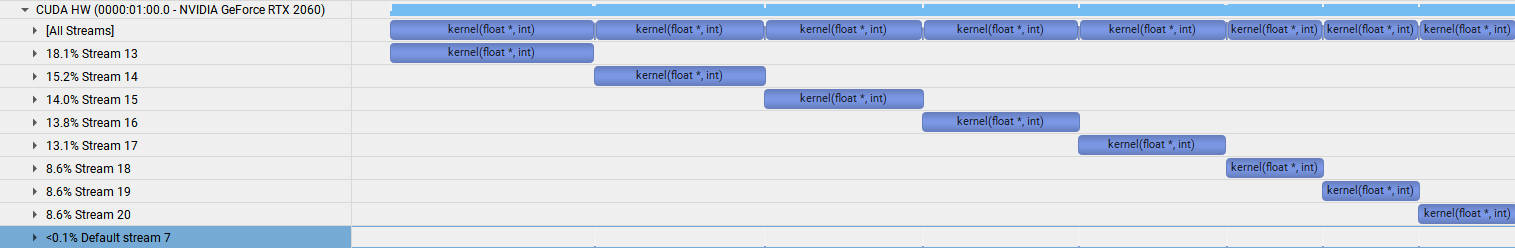
单线程内,默认流的工作方式是同步的,显示流的工作方式是异步的。
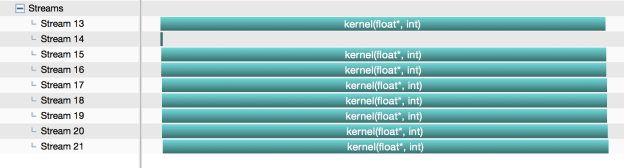
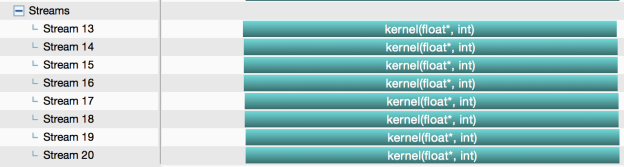
单线程内,编译加上--default-stream per-thread 后,默认流的执行是异步的,显式流的执行是异步的,符合预期。并且会将 default 默认流转换成显示流,才会和其他 8 个显示流进行异步执行。
1 | |
正常编译的话,默认多线程共享一个默认流:

加上--default-stream per-thread之后,编译,每个线程都有一个默认流
1 | |
2.2 streams 的使用
下面看一个例子:计算两个数组对应元素之和并输出到第三个数组中。
-
默认 stream 串行执行
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82#include "cuda_runtime.h"
#include <iostream>
#include <stdio.h>
#include <math.h>
#include <time.h>
#define N (1024*1024) //每次从CPU传输到GPU的数据块大小
#define FULL_DATA_SIZE N*20 //总数据量
__global__ void kernel(int* a, int *b, int*c)
{
int threadID = blockIdx.x * blockDim.x + threadIdx.x;
//这里线程号应该小于FULL_DATA_SIZE
if (threadID < FULL_DATA_SIZE)
{
c[threadID] = (a[threadID] + b[threadID]) / 2;
}
}
//目的:计算两个数组,数组大小均为FULL_DATA_SIZE,的和
int main()
{
int *host_a, *host_b, *host_c;
int *dev_a, *dev_b, *dev_c;
//在GPU上分配内存
cudaMalloc((void**)&dev_a, FULL_DATA_SIZE * sizeof(int));
cudaMalloc((void**)&dev_b, FULL_DATA_SIZE * sizeof(int));
cudaMalloc((void**)&dev_c, FULL_DATA_SIZE * sizeof(int));
//在CPU上分配:可分页内存
//数组大小FULL_DATA_SIZE
host_a = (int*)malloc(FULL_DATA_SIZE * sizeof(int));
host_b = (int*)malloc(FULL_DATA_SIZE * sizeof(int));
host_c = (int*)malloc(FULL_DATA_SIZE * sizeof(int));
//主机上的两个数组随机赋值
for (int i = 0; i < FULL_DATA_SIZE; i++) {
host_a[i] = i;
host_b[i] = FULL_DATA_SIZE - i;
}
//copy host to device
cudaMemcpy(dev_a, host_a, FULL_DATA_SIZE * sizeof(int), cudaMemcpyHostToDevice);
cudaMemcpy(dev_b, host_b, FULL_DATA_SIZE * sizeof(int), cudaMemcpyHostToDevice);
std::cout << "启动 "<< std::endl;
cudaDeviceSynchronize();
//启动计时器
cudaEvent_t start, stop;
float elapsedTime;
cudaEventCreate(&start);
cudaEventCreate(&stop);
cudaEventRecord(start, 0);
//启动函数,做数值加法
kernel <<<FULL_DATA_SIZE / 1024, 1024 >>> (dev_a, dev_b, dev_c);
//数据拷贝回主机
cudaMemcpy(host_c, dev_c, FULL_DATA_SIZE * sizeof(int), cudaMemcpyDeviceToHost);
cudaEventRecord(stop, 0);
cudaEventSynchronize(stop);
cudaEventElapsedTime(&elapsedTime, start, stop);
std::cout << "event计时: " << elapsedTime <<"ms"<< std::endl;
cudaFreeHost(host_a);
cudaFreeHost(host_b);
cudaFreeHost(host_c);
cudaFree(dev_a);
cudaFree(dev_b);
cudaFree(dev_c);
return 0;
}
/*
output:
event计时: 88.3917ms
*/ -
使用一个 stream 异步传输
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98#include "cuda_runtime.h"
#include <iostream>
#include <stdio.h>
#include <math.h>
#define N (1024*1024) //每次从CPU传输到GPU的数据块大小
#define FULL_DATA_SIZE N*20 //总数据量
__global__ void kernel(int* a, int *b, int*c)
{
int threadID = blockIdx.x * blockDim.x + threadIdx.x;
//这里每次计算N个数组
if (threadID < N)
{
c[threadID] = (a[threadID] + b[threadID]) / 2;
}
}
//使用单流:目的:计算两个数组,数组大小均为FULL_DATA_SIZE,的和
int main()
{
//获取设备属性
cudaDeviceProp prop;
int deviceID;
cudaGetDevice(&deviceID);
cudaGetDeviceProperties(&prop, deviceID);
//检查设备是否支持重叠功能,不支持则不能使用多流加速
if (!prop.deviceOverlap)
{
printf("No device will handle overlaps. so no speed up from stream.\n");
return 0;
}
//创建一个CUDA stream
cudaStream_t stream;
cudaStreamCreate(&stream);
int *host_a, *host_b, *host_c;
int *dev_a, *dev_b, *dev_c;
//在GPU上分配内存: GPU上分配的内存大小是N
cudaMalloc((void**)&dev_a, N * sizeof(int));
cudaMalloc((void**)&dev_b, N * sizeof(int));
cudaMalloc((void**)&dev_c, N * sizeof(int));
//在CPU上分配:页锁定内存,使用流的时候,要使用页锁定内存
cudaMallocHost((void**)&host_a, FULL_DATA_SIZE * sizeof(int));
cudaMallocHost((void**)&host_b, FULL_DATA_SIZE * sizeof(int));
cudaMallocHost((void**)&host_c, FULL_DATA_SIZE * sizeof(int));
//主机上的内存赋值
for (int i = 0; i < FULL_DATA_SIZE; i++) {
host_a[i] = i;
host_b[i] = FULL_DATA_SIZE - i;
}
//启动计时器
cudaEvent_t start, stop;
float elapsedTime;
cudaEventCreate(&start);
cudaEventCreate(&stop);
cudaEventRecord(start, 0);
// 内存数据能够在分块传输的同时,GPU也在执行核函数运算,这样的异步操作,可以提升性能
// 将输入缓冲区划分为更小的块,每次向GPU copy N块数据,在stream上执行。并在每个块上执行“数据传输到GPU”,“计算”,“数据传输回CPU”三个步骤
for (int i = 0; i < FULL_DATA_SIZE; i += N) {
//异步将host数据copy到device并执行kernel函数
//因为这个操作是异步的,所以在copy数据的时候,kernel函数就可以开始执行。也就是边copy边执行计算
//比如第一个N块数据拷贝完了,kernel函数就计算,这时第二个N块数据同时进行拷贝。但是如果是没有stream,
//就必须要等到所有数据全部拷贝完再执行计算,这么做可以提高性能
cudaMemcpyAsync(dev_a, host_a + i, N * sizeof(int), cudaMemcpyHostToDevice, stream);
cudaMemcpyAsync(dev_b, host_b + i, N * sizeof(int), cudaMemcpyHostToDevice, stream);
//注意这里开启线程数是N, 第三个参数是shared_memory大小,第四个参数是指定运行kernel的stream
//如果不指定stream则运行在默认stream上
kernel <<<N / 1024, 1024, 0, stream >>> (dev_a, dev_b, dev_c);
cudaMemcpyAsync(host_c + i, dev_c, N * sizeof(int), cudaMemcpyDeviceToHost, stream);
}
cudaEventRecord(stop, 0);
cudaEventSynchronize(stop);
cudaEventElapsedTime(&elapsedTime, start, stop);
std::cout << "消耗时间GPU: " << elapsedTime <<"ms"<< std::endl;
cudaStreamDestroy(stream);
// free stream and mem
cudaFreeHost(host_a);
cudaFreeHost(host_b);
cudaFreeHost(host_c);
cudaFree(dev_a);
cudaFree(dev_b);
cudaFree(dev_c);
return 0;
}
/*
output:
消耗时间GPU: 44.6915ms
*/ -
使用 20 个streams
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101#include <stdio.h>
#include <iostream>
#include <cuda_runtime.h>
#include <device_launch_parameters.h>
#define N_STREAM 20
#define N (1024*1024)
#define FULL_DATA_SIZE (N * N_STREAM)
__global__ void MyKernel(int *a, int *b, int *c){
int threadID = threadIdx.x + blockIdx.x * blockDim.x;
if (threadID < FULL_DATA_SIZE){
c[threadID] = (a[threadID] + b[threadID]) / 2;
}
}
int main(void){
cudaDeviceProp prop;
int whichDevice;
cudaGetDevice(&whichDevice);
cudaGetDeviceProperties(&prop, whichDevice);
if (!prop.deviceOverlap){
printf("Device will not handle overlaps, so no speed up from streams\n");
return 0;
}
cudaEvent_t start, stop;
float elapsedTime;
//启动计时器
cudaEventCreate(&start);
cudaEventCreate(&stop);
cudaEventRecord(start, 0); //在stream0中插入start事件
//初始化N_STREAM个流
cudaStream_t stream[N_STREAM];
for (int i = 0; i < N_STREAM; ++i)
cudaStreamCreate(&stream[i]);
int *host_a, *host_b, *host_c;
int *dev_a0, *dev_b0, *dev_c0;
//在GPU上分配内存: GPU上分配的内存大小是N
cudaMalloc((void **)&dev_a0, FULL_DATA_SIZE * sizeof(int));
cudaMalloc((void **)&dev_b0, FULL_DATA_SIZE * sizeof(int));
cudaMalloc((void **)&dev_c0, FULL_DATA_SIZE * sizeof(int));
//在CPU上分配:页锁定内存,使用流的时候,要使用页锁定内存
cudaHostAlloc((void **)&host_a, FULL_DATA_SIZE * sizeof(int),
cudaHostAllocDefault);
cudaHostAlloc((void **)&host_b, FULL_DATA_SIZE * sizeof(int),
cudaHostAllocDefault);
cudaHostAlloc((void **)&host_c, FULL_DATA_SIZE * sizeof(int),
cudaHostAllocDefault);
//主机上的内存赋值
for (int i = 0; i < FULL_DATA_SIZE; i++){
host_a[i] = i;
host_b[i] = FULL_DATA_SIZE - i;
}
//每个流计算N个数据:比如stream0计算数据0~(N-1), stream1计算数据N~(2N-1)
for (int i = 0; i < N_STREAM; i++) {
//host copy to device
cudaMemcpyAsync(dev_a0 + i * N, host_a + i * N, N, cudaMemcpyHostToDevice, stream[i]);
cudaMemcpyAsync(dev_b0 + i * N, host_b + i * N, N, cudaMemcpyHostToDevice, stream[i]);
MyKernel <<<N / 1024, 1024, 0, stream[i]>>>(dev_a0 + i * N, dev_b0 + i * N, dev_c0 + i * N);
cudaMemcpyAsync(host_c + i * N, dev_c0 + i * N, N, cudaMemcpyDeviceToHost, stream[i]);
}
//在停止应用程序的计时器之前,首先将进行同步
for (int i = 0; i < N_STREAM; ++i)
cudaStreamSynchronize(stream[i]);
cudaEventRecord(stop, 0);//在stream0中插入stop事件
//等待event会阻塞调用host线程,同步操作,等待stop事件.
//该函数类似于cudaStreamSynchronize,只不过是等待一个event而不是整个stream执行完毕
cudaEventSynchronize(stop);
cudaEventElapsedTime(&elapsedTime, start, stop);
std::cout << "消耗时间: " << elapsedTime <<"ms" << std::endl;
//销毁流
for (int i = 0; i < N_STREAM; ++i)
cudaStreamDestroy(stream[i]);
//释放流和内存
cudaFreeHost(host_a);
cudaFreeHost(host_b);
cudaFreeHost(host_c);
cudaFree(dev_a0);
cudaFree(dev_b0);
cudaFree(dev_c0);
return 0;
}
/*
output:
消耗时间: 11.385ms
*/