Transformer架构详解(4):前馈网络FFN深入理解
前馈网络(FFN)是 Transformer 中参数量最大的模块,占据单个 Block 约 2/3 的参数。它负责对每个 token 进行独立的非线性变换,是模型”记忆知识”和”深度推理”的核心载体。本文从 FFN 的结构设计出发,深入剖析激活函数演进、参数量计算、SwiGLU 门控机制,并延伸到张量并行切分、MoE 专家并行和 CUDA kernel 融合等 AI Infra 工程实践。
一、FFN 架构
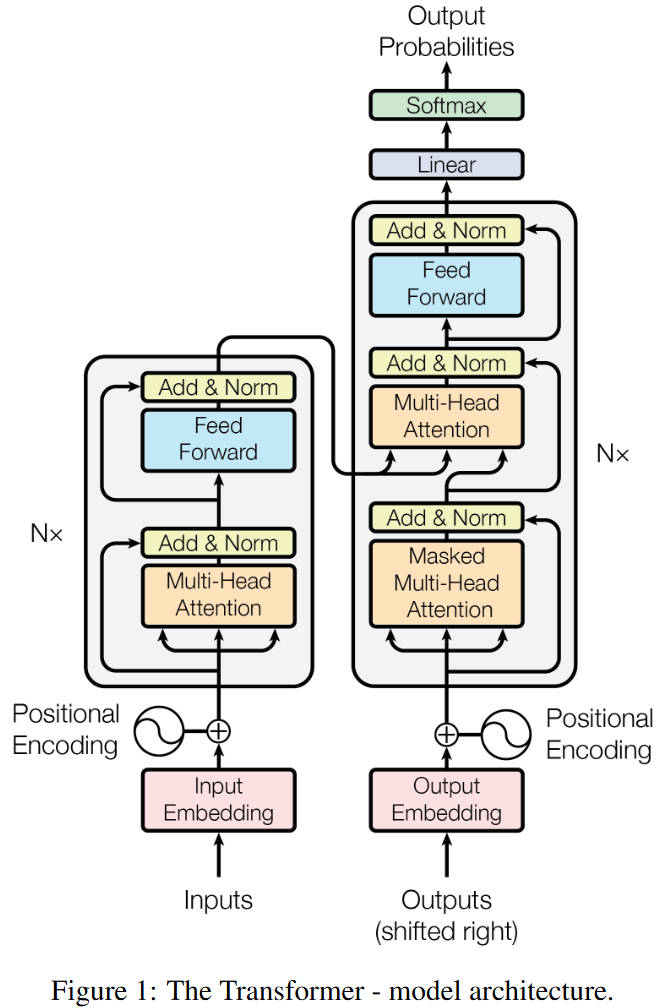
FFN 是 Transformer 的关键组装件之一,下图是 Transformer 的整体架构,包括 Encoder 和 Decoder 两个部分。其中的 Feed Forward 就是前馈神经网络(Feed forward Neural Network,简称 FFN 或 FNN ),又称为全连接层(Fully Connected Layer)或密集层(Dense Layer)。在Transformer模型中,FFN层通常出现在编码器(Encoder)和解码器(Decoder)的注意力层之后。
将 FFN层进行展开,其主要包括三个部分,如下图所示:
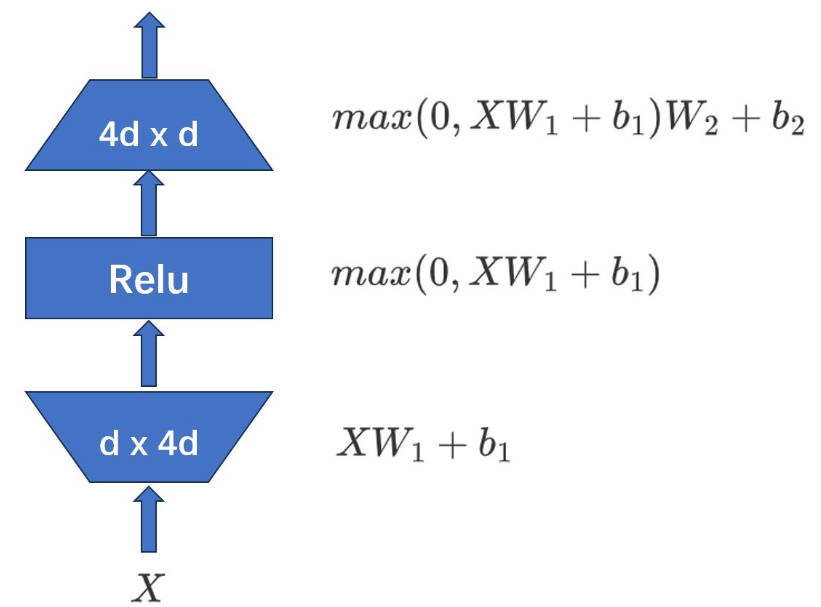
- 升维线性变换:输入首先经过一个线性变换,将输入映射到一个高维空间。这个线性变换通常由一个权重矩阵和一个偏置向量实现(有些大模型架构也会把
bias省略掉)。 - 非线性激活函数:经过生维线性变换后,输入会通过一个激活函数,增加模型的非线性表达能力。常用的激活函数包括ReLU、Sigmoid、Tanh等,顺便说一下,当前主流大模型常用的 SwiGLU。
- 降维线性变换:经过激活函数后,再进行一次线性变换,利用降维矩阵将高维空间的特征映射回原始空间,得到FFN层的输出。
Self-Attention 的职责是信息交互——让序列中的每个 token 能够”看见”其他 token 并汇聚相关信息。打个比方,如果把一个 Transformer Block 看作一家工厂的生产流水线,Self-Attention 就是流水线上的”原料分拣站”:它根据订单需求(Query)从仓库中各个货架(Key)上挑选相关原料(Value),把需要的材料汇集到一起。
而 FFN 则是紧随其后的”加工车间”。原料分拣完毕后,需要在加工车间里对每份原料进行独立的深加工——切割、熔炼、塑形——把粗加工的信息变成精细的、有结构的产出。关键在于:加工车间里的每条生产线是独立运作的,每个 token 各走各的生产线,彼此之间不再交互。
用更技术性的语言来说:
- Self-Attention 是 token 间的运算——输出依赖于序列中所有 token 的组合关系
- FFN 是 token 内的运算——对每个 token 的表示向量独立施加相同的非线性变换
二、FFN 数学表示
2.1 基本结构
标准 FFN 的数学表达式非常简洁:
-
-
-
-
-
为什么要先升维再降维?
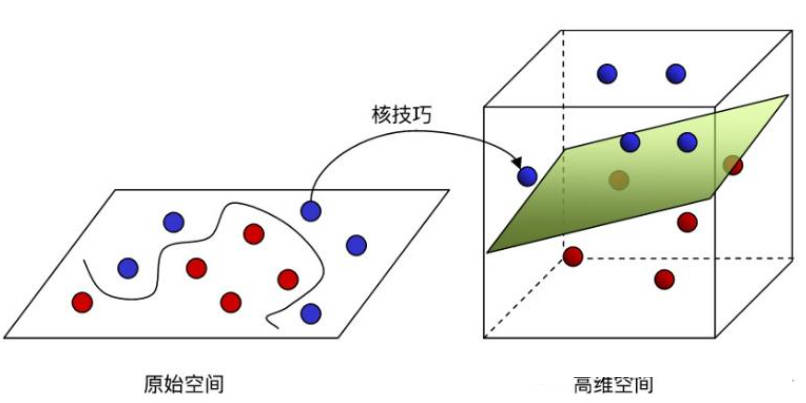
- **高维空间中线性可分性更好。**这是统计学习中的经典原理。想象你有一堆红球和蓝球混在一条线上(一维),很难找到一个点把它们完美分开。但如果你把这些球抛到一个三维空间中(升维),它们就更容易被一个平面分开。FFN 的第一层
就是在做这件事——把信息投射到一个更高维的空间,让不同的特征模式在高维空间中更容易被区分和操作
- **激活函数在高维空间中更有效。**非线性激活函数的作用是选择性地保留或抑制某些信息通道。在高维空间中,每个维度可以被看作一个独立的”特征检测器”,激活函数决定哪些检测器被激活、哪些被关闭。维度越高,可以同时检测的特征模式越多,模型的表达能力就越强
- **降维是信息蒸馏。**第二层
将高维空间中被激活函数筛选过的信息压缩回原始维度。这个过程迫使模型只保留最重要的信息 - **与 Autoencoder 的类比。**自编码器(Autoencoder)和 FFN 的结构正好是反过来的。Autoencoder 先压缩再还原(编码-解码),用来学习数据的低维表示;FFN 先展开再压缩(展开-蒸馏),用来在高维空间中进行复杂的非线性变换后提取有用信息
2.2 代码实现
1 | |
三、激活函数
激活函数是 FFN 中至关重要的组件。没有激活函数,两层线性变换的复合仍然是线性变换(
3.1 ReLU - Rectified Linear Unit
ReLU 是最朴素的”开关”函数——输入为正就原样通过,输入为负就直接关闭。ReLU 就像一个单向阀门:水(信号)只能从正方向流过,负方向完全截断。
- 输出范围:
- 正半轴梯度恒为 1,不存在梯度衰减问题
- 负半轴梯度恒为 0,输出恒为 0
- 计算极其高效:只需一次比较操作
优点:
- 计算简单,硬件友好——在 GPU 上只需一个 max 操作
- 正半轴梯度为 1,缓解了深层网络的梯度消失问题(相比 sigmoid/tanh)
- 引入稀疏性:负值被置零,激活后的向量通常有大量零元素,有利于特征的稀疏表示
缺点:神经元死亡问题(Dying ReLU)
当某个神经元的输入在训练过程中恰好落入负区间,ReLU 的输出为 0,梯度也为 0。零梯度意味着该神经元的权重在反向传播时得不到任何更新信号。而权重没有更新,下一轮前向传播时输入大概率仍然为负——于是这个神经元永久性地”死亡”了,不再对模型的计算做出任何贡献。
这个问题在学习率较大时尤为严重。一次大幅度的梯度更新可能把权重推到一个”坏”的区域,使得该神经元对所有训练样本的输出都为负,从此一蹶不振。在实际训练中,有时候会观察到超过 40% 的 ReLU 神经元处于”死亡”状态,这意味着模型有效容量大幅缩水。
LeakyReLU 通过给负半轴一个微小的斜率(如 0.01x)来缓解这个问题,但这只是打了个补丁,并没有从根本上解决激活函数在零点处不光滑、不可微的问题。
3.2 GELU - Gaussian Error Linear Unit
-
实际计算中常用近似公式:
GELU 的核心思想是把激活看作一种”概率性门控”。对于输入 x,GELU 计算的是”以概率
为什么用正态分布的 CDF 作为保留概率?这基于一个直觉假设:如果我们认为神经网络中的输入信号近似服从正态分布(根据中心极限定理,多个随机变量之和趋向正态分布),那么一个输入值越大(越偏离均值向右),它越可能是”有意义的信号”而非噪声,就越应该被保留。
与 ReLU 的硬切换(0 或全通过)相比,GELU 实现了一种”软门控”——接近零的输入不会被完全截断,而是按照一个与其大小成正比的概率被保留。
- 输出范围:约
- 处处光滑可微,没有 ReLU 在零点处的不可微问题
- 负值区域输出非零但极小,梯度也非零,不存在神经元死亡问题
- 近似于 ReLU 但更平滑:大正值时 GELU(x) 趋近 x,大负值时趋近 0
优点:
- 平滑可微,训练更稳定
- 概率化门控使信息保留更加精细
- 在 BERT、GPT-2 等模型中被验证效果优于 ReLU
缺点:
- 计算量比 ReLU 大(涉及 erf 函数或 tanh 近似)
- 但在现代 GPU 上,计算开销差异相对于 GEMM 而言几乎可忽略
3.3 Swish
-
-
Swish 可以看作是 ReLU 和线性函数之间的一种自适应插值。sigmoid 函数
当 x 为大正值时,
- 输出范围:约
- 处处光滑可微
- 非单调函数——在负半轴有一个小的下凹区域
- 当
Swish 的平滑性在训练中带来了实质性的好处。ReLU 在 x=0 处梯度不连续(左导数为 0,右导数为 1),这意味着优化过程中的损失曲面(loss landscape)存在”棱角”。梯度下降算法在这些不光滑的点附近容易产生震荡。
Swish 的处处可微性质使损失曲面更加光滑,梯度信号在整个定义域上连续变化,优化过程更加稳定。Google Brain 的研究表明,Swish 在深层网络中的表现一致优于 ReLU,尤其是在网络深度超过 40 层时优势更为明显。
3.4 SwiGLU
SwiGLU 是 Noam Shazeer 在 2020 年的论文”GLU Variants Improve Transformer”中提出的 GLU 变体,将门控中的 sigmoid 替换为 Swish 函数:
完整的 SwiGLU FFN 包含三个权重矩阵:
其中:
-
-
-
-
更精细的信息筛选。 标准 FFN 中,激活函数对升维后的每个维度施加相同的变换规则——一个全局的非线性函数。SwiGLU 的门控机制则允许模型对每个维度施加不同的”通过/抑制”决策。这意味着模型可以学到更加条件化的计算——“当输入具有特征 A 时,保留这些维度;当输入具有特征 B 时,保留那些维度。”
-
更丰富的梯度信号。 由于门控路径和内容路径是两个独立的线性投影,反向传播时梯度可以沿着两条路径分别回传,参数的更新信号更加丰富。这可以理解为一种隐式的”梯度高速公路”——与残差连接的思想异曲同工
-
实验验证。 Shazeer 的论文在相同参数量的条件下对比了多种 GLU 变体,SwiGLU 在多个下游任务上一致地取得了最佳表现。后来 LLaMA、Mistral、Qwen、DeepSeek 等主流大模型纷纷采用 SwiGLU,在工业实践中进一步验证了其有效性
代码实现:
1 | |
四、FFN 中间维度的选择
6.1 标准 FFN 为什么选择 4 倍扩展
为什么是 4 倍而不是 2 倍或 8 倍?这在很大程度上是经验性的选择。从直觉上说:
- 太小(如 2x):高维空间不够大,非线性变换的表达能力受限,模型效果下降
- 太大(如 8x):参数量急剧膨胀,但效果提升边际递减,参数效率降低
- 4x 是一个平衡点:在模型效果和参数效率之间取得较好的折中
后续研究(如 Kaplan 等人关于 Scaling Laws 的工作)也表明,在固定总参数量的前提下,
6.2 SwiGLU 为什么用 8/3 倍扩展
SwiGLU 将标准 FFN 的 2 个矩阵变成了 3 个矩阵。如果继续使用
这比标准 FFN 的
以
在工程实现中,
以 LLaMA-2-7B 为例:10922.67 取整到 11008(=43×256=43×256),这就是我们看到的 LLaMA 配置中