Transformer架构详解(5):残差连接与层归一化
一、为什么需要残差连接和层归一化
神经网络的训练依赖反向传播(Backpropagation),其本质是链式法则(Chain Rule)的递归应用。假设一个 L 层的网络,每层的变换为
这是一连串乘法。想象你在玩一个”传话游戏”:消息从队尾传到队首,每个人都会对消息做一次”缩放”处理再传给下一个人。如果每个人都把消息音量缩小 10%,经过 50 个人之后,消息几乎听不见了——这就是梯度消失。反过来,如果每个人都把音量放大 10%,经过 50 个人之后就变成了震耳欲聋的噪声——这就是梯度爆炸。
用数学来说,假设每层的雅可比矩阵的谱范数(最大奇异值)为
- 若
- 若
- 只有 $ \sigma $ 恰好等于 1 的理想情况下,梯度才能稳定传播——但这在实际训练中几乎不可能自然满足
这个问题随着网络深度的增加而急剧恶化。在 Transformer 出现之前,LSTM 通过门控机制部分缓解了梯度消失;但对于动辄几十上百层的 Transformer 来说,我们需要更根本、更直接的解决方案。
2015 年,何恺明等人在训练深层卷积网络时发现了一个反直觉的现象:更深的网络反而比浅层网络表现更差——不是因为过拟合(训练误差也更高),而是因为优化本身出了问题。理论上,一个 56 层网络至少不应该比 20 层网络差,因为多出来的 36 层只要学成恒等映射(identity mapping),就能保持 20 层的效果。但实际训练中,让网络”学会什么都不做”远比我们想象的困难。
二、残差连接
2.1 从 ResNet 到 Transformer
2015 年底,何恺明等人提出了 ResNet(Residual Network),用一个极其简洁的结构解决了上述退化问题:
- x 是层的输入
- F(x) 是需要学习的转换(称为“残差函数”)
2017 年,Vaswani 等人在设计 Transformer 时直接采用了残差连接。在 Transformer 的每个 Decoder Block 中,Attention 子层和 FFN 子层各有一条残差连接:
对于一个包含 32 个 Block 的 LLaMA-7B 模型,信号从第 1 层到第 32 层需要经过 64 个子层。没有残差连接,梯度几乎不可能穿越这么多层而不消失。
2.2 数学原理
下面从反向传播的角度,严格地看看残差连接为什么有效。
无残差连接的情况:
假设每一层的计算为
这是一连串雅可比矩阵的乘法。任何一个因子的谱范数偏离 1,经过多层累乘都会导致梯度消失或爆炸。
有残差连接的情况:
每一层的计算变为
其中
把这个连乘展开后,其中必然包含一项恒为
关键在于这个
从另一个角度看,残差连接把反向传播中的纯”乘法链”变成了”加法 + 乘法”的混合结构。纯乘法链对数值极其敏感(想想连续乘以 0.9 五十次的结果),而加法的引入让梯度有了一个”保底值”,大幅提升了数值稳定性。
2.3 代码实现
1 | |
三、归一化
残差连接解决了梯度能否传回去的问题,但还有另一个同样严峻的挑战:特征分布的漂移(Internal Covariate Shift)。随着训练进行,每一层的输入分布不断变化,后续层必须不断适应前面层的”新脾气”,导致训练不稳定且收敛缓慢。归一化技术的目标就是把每一层的输入拉回到一个稳定的分布区间,让各层能安心学自己的参数。
3.1 BatchNorm
BatchNorm(Batch Normalization,2015 年 Ioffe 和 Szegedy 提出)沿 batch 维度 对每个特征做归一化。对于一个形状为
即:对每个特征通道,统计这个 batch 内所有样本在该通道上的均值和方差,然后做标准化。γ 和 β 是可学习的参数,用于恢复表达能力。
BatchNorm 在 CV 领域取得了巨大成功——它让 CNN 的训练速度和稳定性都有了质的飞跃。但把它搬到 NLP 和 Transformer 中时,会遇到几个根本性的困难:
- 序列长度不等:NLP 中同一个 batch 内的句子长度通常不同。即使做了 padding,短句 padding 位置的特征值是无意义的,将其纳入均值/方差的计算会引入噪声。
- Batch 维度统计不稳定:在大模型训练中,受显存限制,单卡的 micro batch size 可能很小(比如 1-4)。用极少的样本去估计 batch 统计量,方差本身就很大,归一化的效果很不可靠。
- 推理时的不一致性:训练时用 batch 统计量,推理时用指数移动平均(running mean/variance),两个分布可能不完全匹配,造成训练-推理不一致。
- 自回归生成不友好:Decoder 模型在推理时逐 token 生成,此时 batch size 为 1,batch 统计量完全没有意义。
3.2 LayerNorm
LayerNorm(Layer Normalization,2016 年 Jimmy Ba 等人提出)转换了归一化的方向:不是沿 batch 维度,而是沿特征维度对每个样本独立做归一化。对于一个形状为
特点:
- 完全独立于 batch:每个 token 的归一化只依赖自身的 dd 维特征,与 batch 中其他样本无关,避免了 BatchNorm 的所有问题。
- 不受序列长度影响:不同长度的句子中的 token 各自独立归一化,长度不等完全不是问题。
- 训练和推理行为一致:没有 running mean/variance,训练和推理时的计算逻辑完全相同。
- 自回归友好:逐 token 生成时,每个 token 可以独立归一化,不需要依赖其他 token。
3.3 RMSNorm
2019 年,Biao Zhang 和 Rico Sennrich 提出了 RMSNorm(Root Mean Square Layer Normalization)。他们提出了一个大胆的假设:LayerNorm 的效果主要来自”重新缩放(re-scaling)“而非”重新中心化(re-centering)“。也就是说,减去均值那一步或许并不是必需的。
RMSNorm 去掉了均值的计算,只保留了基于均方根(Root Mean Square)的缩放:
两个关键简化:
- 去掉了均值的计算:不做 re-centering,直接用 RMS 归一化
- 通常去掉了 β 参数:没有 re-centering 也就不需要偏移项
从数学上看,RMS(x) 和标准差 std(x) 的关系为:
当 mean(x) 接近 0 时,RMS(x) 近似等于 std(x),RMSNorm 和 LayerNorm 的行为基本一致。实验表明,在深层 Transformer 中,各层特征向量的均值确实通常接近于零(尤其在 Pre-Norm 架构中,因为残差连接会不断累加,均值的相对比重越来越小),这为 RMSNorm 的有效性提供了直觉解释。
四、Pre-Norm & Post-Norm
LayerNorm 放在子层的前面还是后面,看起来只是一个微不足道的顺序调整,但对大模型的训练稳定性有着决定性的影响。
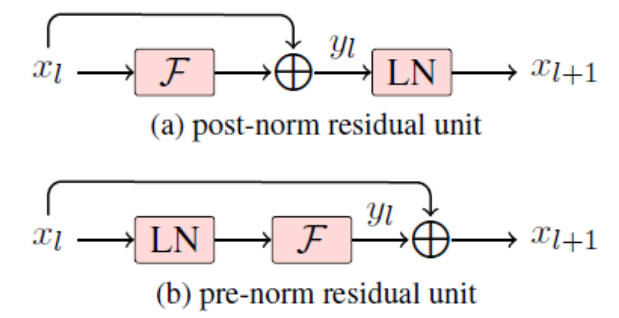
4.1 对比
Post-Norm(原始 Transformer 论文,Vaswani et al. 2017)
1 | |
计算公式:output = LayerNorm(x + SubLayer(x))
Pre-Norm(GPT-2 开始采用,现已成为主流)
1 | |
计算公式:output = x + SubLayer(LayerNorm(x))
4.2 梯度分析
两种架构的根本区别在于残差路径是否”干净”。
Post-Norm 的梯度流
在 Post-Norm 中,残差加法的结果要再经过一次 LayerNorm。从反向传播的角度看,梯度从第 L 层回传到第 l 层时,每经过一个 Block 都要被 LayerNorm 的雅可比矩阵”调制”一次:
LayerNorm 的雅可比矩阵并不是单位阵——它涉及均值和方差的梯度,会对回传的梯度做一次非平凡的线性变换。这些变换累乘起来,可能导致梯度的方向和大小发生显著变化。在深层网络中(比如 96 层的 GPT-3),这种累积效应可能引发梯度爆炸,需要精心设计学习率 warmup 策略来抑制。
Pre-Norm 的梯度流
在 Pre-Norm 中,残差加法之后没有任何操作,输出直接传入下一层。梯度从第 L 层到第 l 层的传播为:
注意这里每个因子都是 ”
简单来说,Pre-Norm 让残差路径保持”纯净”,梯度可以无损地穿越任意多层,训练自然更加稳定。
4.3 总结
多篇论文的实验结果指向一致的结论:
- Pre-Norm 对学习率更鲁棒:Xiong et al.(2020, “On Layer Normalization in the Transformer Architecture”)通过理论分析证明,Post-Norm 在初始化时各层输出的方差会随深度线性增长,必须用较小的学习率和较长的 warmup 来抑制;而 Pre-Norm 各层方差天然保持稳定,可以省略 warmup 直接使用较大的学习率。
- Post-Norm 的理论优势在实践中很难兑现:有研究表明 Post-Norm 在训练充分收敛时效果略好于 Pre-Norm(约 0.1-0.5 BLEU 点),但这需要极其精细的超参数调优。当模型规模增大到数十亿参数以上,Post-Norm 经常出现 loss spike(损失突然飙升)甚至训练发散,而 Pre-Norm 则稳如泰山。
- 大规模训练零容忍不稳定:训练一个 175B 参数的模型可能需要花费数百万美元的算力成本。一次训练发散意味着前功尽弃,重新来过。在这种约束下,Pre-Norm 提供的稳定性保障远比 Post-Norm 可能带来的微小效果提升更有工程价值。
4.4 DeepNorm
尽管 Pre-Norm 已经是主流,研究者仍在探索能否兼得两者优点。2022 年,微软提出的 DeepNorm 是一种值得注意的混合方案:
其中
- 残差路径乘以
- SubLayer 的参数按特定规则缩小初始化(乘以
-
这样做的效果是:在形式上采用 Post-Norm 的结构(可能获得更好的最终效果),但通过放大残差路径和缩小子层输出,实现了类似 Pre-Norm 的梯度稳定性。微软用 DeepNorm 成功训练了 1000 层的 Transformer。
不过在实际的开源大模型中,DeepNorm 的采用率远不如 Pre-Norm。原因很简单:Pre-Norm 足够好用,工程实现简单,社区验证充分,没有引入额外超参数的必要。